هموارسازی نمایی
هموارسازی نمایی یا میانگین متحرک نمایی (EMA)، تکنیکی برای هموارسازی دادههای سری زمانی با استفاده از تابع پنجره نمایی است. در حالی که در میانگین متحرک ساده، مشاهدات گذشته به طور مساوی وزندهی میشوند، در توابع نمایی از وزنهایی استفاده میشود که با گذشت زمان به صورت نمایی کاهش مییابند. این روش، رویهای ساده برای یادگیری و بهکارگیری است که بر اساس پیشفرضهای کاربر (مانند فصلی بودن)، تصمیمگیریهایی را انجام میدهد. هموارسازی نمایی اغلب برای تحلیل دادههای سری زمانی استفاده میشود.
هموارسازی نمایی یکی از بسیاری از توابع پنجره است که معمولاً برای هموارسازی دادهها در پردازش سیگنال به کار میرود و به عنوان فیلتر پایینگذر برای حذف نویز با فرکانس بالا عمل میکند. پیشینه این روش به استفاده پواسون از توابع پنجره نمایی بازگشتی در همگشتها در قرن نوزدهم، و همچنین استفاده کولموگروف و زوربنکو از میانگینهای متحرک بازگشتی در مطالعاتشان بر روی تلاطم در دهه ۱۹۴۰ میلادی بازمیگردد.
دنباله دادههای خام معمولاً با که از زمان آغاز میشود، نمایش داده میشود و خروجی الگوریتم هموارسازی نمایی معمولاً به صورت نوشته میشود که میتوان آن را بهترین برآورد از مقدار بعدی در نظر گرفت. هنگامی که دنباله مشاهدات از زمان آغاز میشود، سادهترین شکل هموارسازی نمایی توسط فرمولهای زیر ارائه میشود:[۱]:


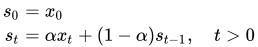
که در آن «ضریب هموارسازی» است و . اگر به طور پیوسته در جایگذاری شود تا فرمول به طور کامل بر حسب بیان شود، آنگاه عوامل وزندهی با کاهش نمایی بر روی هر داده خام آشکار میشود که نشاندهنده دلیل نامگذاری هموارسازی نمایی است.


هموارسازی نمایی ساده قادر نیست آنچه را که در بر اساس دادههای خام تا زمان مشاهده میشود، پیشبینی کند؛ در حالی که هموارسازی نمایی دوگانه و هموارسازی نمایی سهگانه به دلیل وجود به عنوان دنبالهای از بهترین برآوردها از روند خطی، میتوانند برای پیشبینی استفاده شوند.


هموارسازی نمایی پایه (ساده)
استفاده از تابع پنجره نمایی نخستین بار به پواسون[۲] به عنوان گسترشی از یک تکنیک تحلیل عددی از قرن هفدهم نسبت داده شد و بعدها در دهه ۱۹۴۰ توسط جامعه پردازش سیگنال به کار گرفته شد. در اینجا، هموارسازی نمایی، کاربرد تابع پنجره نمایی یا پواسون است. هموارسازی نمایی در متون آماری بدون ارجاع به کارهای پیشین، توسط رابرت گودل براون در سال ۱۹۵۶ پیشنهاد شد[۳] و توسط چارلز سی. هولت در سال ۱۹۵۷ گسترش یافت.[۴] فرمولبندی زیر که بهطور معمول استفاده میشود، به براون نسبت دادهشده و به عنوان «هموارسازی نمایی ساده براون» شناخته میشود.[۵] تمام روشهای هولت، وینترز و براون را میتوان به عنوان کاربرد سادهای از فیلتر بازگشتی دانست که نخستین بار در دهه ۱۹۴۰[۲] برای تبدیل فیلترهای پاسخ ضربه محدود (FIR) به فیلترهای پاسخ ضربه نامحدود یافت شد.
سادهترین شکل هموارسازی نمایی با فرمول زیر ارائه میشود:
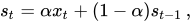
که در آن «ضریب هموارسازی» است و . به عبارت دیگر، آماره هموارشده یک میانگین وزنی ساده از مشاهده جاری و آماره هموارشده پیشین است. هموارسازی نمایی ساده به آسانی اعمال میشود و به محض در دسترس بودن دو مشاهده، یک آماره هموارشده تولید میکند. اصطلاح «ضریب هموارسازی» که در اینجا برای به کار میرود، تا حدودی نامگذاری نادرستی است، زیرا مقادیر بزرگتر در واقع سطح هموارسازی را کاهش میدهند و در حالت حدی با ، سری خروجی هموارشده صرفاً همان مشاهده جاری است. مقادیر نزدیک به ۱ اثر هموارسازی کمتری دارند و وزن بیشتری به تغییرات اخیر در دادهها میدهند، در حالی که مقادیر نزدیک به ۰ اثر هموارسازی بیشتری دارند و نسبت به تغییرات اخیر واکنش کمتری نشان میدهند. در حالت حدی با ، سری خروجی صرفاً تخت یا ثابت است، زیرا مشاهده در ابتدای فرایند هموارسازی در قرار دارد.


روش انتخاب باید توسط مدلساز تعیین شود. گاهی اوقات از قضاوت آماردان برای انتخاب ضریب مناسب استفاده میشود. به عنوان جایگزین، میتوان از یک تکنیک آماری برای «بهینهسازی» مقدار استفاده کرد. برای مثال، ممکن است از روش کمترین مربعات برای تعیین مقداری از استفاده شود که در آن مجموع مقادیر کمینه شود.[۶]

برخلاف برخی دیگر از روشهای هموارسازی، مانند میانگین متحرک ساده، این تکنیک پیش از شروع تولید نتایج، نیازی به حداقل تعداد مشاهدات ندارد. با این حال، در عمل، یک «میانگین خوب» تا زمانی که چندین نمونه با هم میانگینگیری نشوند، حاصل نخواهد شد؛ برای مثال، یک سیگنال ثابت تقریباً به مرحله نیاز دارد تا به ۹۵٪ مقدار واقعی برسد. برای بازسازی دقیق سیگنال اصلی بدون از دست دادن اطلاعات، تمام مراحل میانگین متحرک نمایی نیز باید در دسترس باشند، زیرا وزن نمونههای قدیمیتر به صورت نمایی کاهش مییابد. این در تضاد با میانگین متحرک ساده است که در آن به دلیل وزندهی ثابت نمونهها در میانگین، میتوان برخی نمونهها را بدون از دست دادن اطلاعات زیاد نادیده گرفت. اگر تعداد مشخصی از نمونهها از دست بروند، میتوان با دادن وزن برابر به نمونه جدید و تمام نمونههایی که قرار است نادیده گرفته شوند، میانگین وزنی را برای این مورد نیز تنظیم کرد.

این شکل ساده از هموارسازی نمایی به عنوان میانگین متحرک نمایی (EWMA) نیز شناخته میشود. از نظر فنی، این روش را میتوان به عنوان یک مدل میانگین متحرک خودهمبسته یکپارچه (ARIMA) (0,1,1) بدون جمله ثابت طبقهبندی کرد.[۷]
ثابت زمانی
ثابت زمانی یک میانگین متحرک نمایی، مقدار زمانی است که طول میکشد تا پاسخ هموارشده یک تابع پله واحد به مقدار نهایی برسد. رابطه بین این ثابت زمانی، ، و ضریب هموارسازی، ، با فرمول زیر داده میشود::، بنابراین
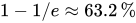

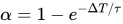
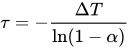
که در آن بازه زمانی نمونهبرداری در پیادهسازی زمان گسسته است.

برخی کتابخانههای ریاضی تابع expm1(x) = exp(x) - 1 را برای ارائه نتایج دقیقتر زمانی که x نزدیک به ۰ است فراهم میکنند و میتوان از آن مستقیماً برای محاسبه استفاده کرد::
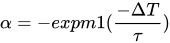
به همین ترتیب، تابع معکوس log1p(x) = log(1+x) را میتوان برای محاسبه ثابت زمانی از ضریب هموارسازی به کار برد::
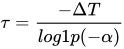
اما اگر زمان نمونهبرداری در مقایسه با ثابت زمانی بسیار کوچک باشد ()، آنگاه با استفاده از بسط تیلور تابع نمایی،:، بنابراین


انتخاب مقدار هموارشده اولیه
توجهداشته باشید که در تعریف بالا، (خروجی اولیه الگوریتم هموارسازی نمایی) با (دادههای خام یا مشاهده اولیه) مقداردهی اولیه میشود. از آنجا که هموارسازی نمایی مستلزم آن است که در هر مرحله، پیشبینی قبلی راداشته باشیم، مشخص نیست که چگونه باید روش را آغاز کرد. میتوان فرض کرد که پیشبینی اولیه برابر با مقدار اولیه تقاضا است؛ با این حال، این رویکرد یک نقطه ضعف جدی دارد. هموارسازی نمایی وزن قابل توجهی به مشاهدات گذشته میدهد، بنابراین مقدار اولیه تقاضا تأثیر نامعقولی بر پیشبینیهای اولیه خواهد داشت. این مشکل را میتوان با اجازه دادن به فرایند برای تکامل در تعداد معقولی از دورهها (۱۰ یا بیشتر) و استفاده از میانگین تقاضا در طول آن دورهها به عنوان پیشبینی اولیه برطرف کرد. روشهای بسیار دیگری برای تعیین این مقدار اولیه وجود دارد، اما هرچه مقدار کوچکتر باشد، پیشبینی نسبت به انتخاب این مقدار هموارشده اولیه حساستر خواهد بود.[۸][۹]


بهینهسازی
برای هر روش هموارسازی نمایی، ما همچنین باید مقداری را برای پارامترهای هموارسازی انتخاب کنیم. برای هموارسازی نمایی ساده، تنها یک پارامتر هموارسازی (α) وجود دارد، اما برای روشهایی که در ادامه میآیند، معمولاً بیش از یک پارامتر هموارسازی وجود دارد.
مواردی وجود دارد که پارامترهای هموارسازی ممکن است به صورت ذهنی انتخاب شوند – پیشگو مقدار پارامترهای هموارسازی را بر اساس تجربه قبلی مشخص میکند. با این حال، یک روش قویتر و عینیتر برای به دست آوردن مقادیر پارامترهای ناشناخته موجود در هر روش هموارسازی نمایی، برآورد آنها از دادههای مشاهدهشده است.
پارامترهای ناشناخته و مقادیر اولیه برای هر روش هموارسازی نمایی را میتوان با کمینه کردن مجموع مربعات خطاها (SSE) برآورد کرد. خطاها به صورت برای (خطاهای پیشبینی یکگامجلوتر دروننمونهای) مشخص میشوند که در آن و به ترتیب متغیری هستند که باید در پیشبینی شود و متغیری به عنوان نتیجه پیشبینی در (بر اساس دادهها یا پیشبینی قبلی) میباشند. از این رو، ما مقادیر پارامترهای ناشناخته و مقادیر اولیهای را مییابیم که موارد زیر را کمینه میکنند:: [۱۰]
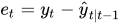


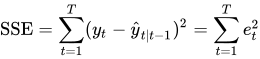
برخلاف حالت رگرسیون (که در آن فرمولهایی برای محاسبه مستقیم ضرایب رگرسیون جهت کمینهسازی SSE داریم)، این مورد شامل یک مسئله کمینهسازی غیرخطی است و برای انجام آن نیاز به استفاده از یک ابزار بهینهسازی داریم.
نامگذاری «نمایی»
نام «هموارسازی نمایی» به استفاده از تابع نمایی به عنوان پاسخ ضربه فیلتر در همگشت نسبت داده میشود.
با جایگذاری مستقیم معادله تعریفکننده هموارسازی نمایی ساده در خودش، درمییابیم که::
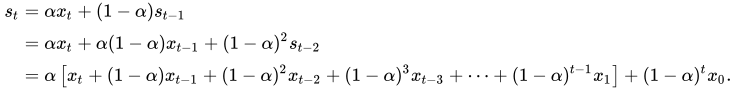
به عبارت دیگر، با گذشت زمان، آماره هموارشده به میانگین وزنی تعداد بیشتری از مشاهدات گذشته یعنی تبدیل میشود و وزنهای اختصاصیافته به مشاهدات قبلی متناسب با جملات تصاعد هندسی زیر است::
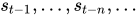
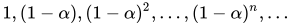
یک تصاعد هندسی نسخه گسسته یک تابع نمایی است، بنابراین طبق دانستههای آمار، نام این روش هموارسازی از اینجا نشأت گرفته است.
مقایسه با میانگین متحرک
هموارسازی نمایی و میانگین متحرک دارای نقصهای مشابهی در ایجاد تأخیر نسبت به دادههای ورودی هستند. اگرچه این مورد برای یک هسته متقارن (مانند میانگین متحرک یا گاوسی) با جابهجایی نتیجه به اندازه نصف طول پنجره قابل اصلاح است، اما این رویکرد برای هموارسازی نمایی ممکن نیست؛ زیرا این روش یک فیلتر IIR است و در نتیجه دارای هسته نامتقارن و تأخیر گروهی وابسته به فرکانس میباشد. این بدان معناست که هر فرکانس تشکیلدهنده به میزان متفاوتی جابهجا میشود و بنابراین، هیچ تعداد نمونه واحدی وجود ندارد که بتوان از آن برای جابهجایی سیگنال خروجی جهت جبران تأخیر استفاده کرد.
هر دو فیلتر تقریباً توزیع خطای پیشگویی یکسانی دارند، زمانی که باشد که در آن تعداد نقاط داده گذشته در نظر گرفتهشده در میانگین متحرک است. تفاوت آنها در این است که هموارسازی نمایی تمام دادههای گذشته را در نظر میگیرد، در حالی که میانگین متحرک تنها نقطه داده گذشته را لحاظ میکند. از نظر محاسباتی، آنها همچنین تفاوت دارند؛ زیرا میانگین متحرک مستلزم نگهداری نقطه داده گذشته یا نقطه داده در تأخیر به علاوه آخرین مقدار پیشگوییشده است، در حالی که هموارسازی نمایی تنها به نگهداری آخرین مقدار پیشگوییشده نیاز دارد.[۱۱]
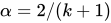


در ادبیات پردازش سیگنال، استفاده از فیلترهای غیرعلی (متقارن) رایج است و تابع پنجره نمایی به طور گستردهای به این شکل استفاده میشود، اما اصطلاحات متفاوتی به کار میرود: هموارسازی نمایی معادل یک فیلتر پاسخ ضربه نامحدود (IIR) مرتبه اول است و میانگین متحرک معادل یک فیلتر پاسخ ضربه محدود با عوامل وزنی برابر است.
هموارسازی نمایی دوگانه (هولت خطی)
هموارسازی نمایی ساده زمانی که روندی در دادهها وجودداشته باشد، عملکرد خوبی ندارد.[۱] در چنین شرایطی، روشهای متعددی تحت عنوان «هموارسازی نمایی دوگانه» یا «هموارسازی نمایی مرتبه دوم» ابداع شدند که عبارت است از کاربرد بازگشتی یک فیلتر نمایی برای دو بار، که به همین دلیل «هموارسازی نمایی دوگانه» نامیده میشود. ایده اصلی پشت هموارسازی نمایی دوگانه، معرفی جملهای برای در نظر گرفتن احتمال وجود نوعی روند در سری است. این مولفه شیب، خود از طریق هموارسازی نمایی بهروزرسانی میشود.
یک روش به صورت زیر عمل میکند:[۱۲]
دوباره، دنباله دادههای خام مشاهدات با نشان داده میشود که از زمان آغاز میگردد. ما از برای نمایش مقدار هموارشده برای زمان استفاده میکنیم و بهترین برآورد ما از روند در زمان است. خروجی الگوریتم اکنون به صورت نوشته میشود که برآوردی از مقدار در زمان بر اساس دادههای خام تا زمان است. هموارسازی نمایی دوگانه توسط فرمولهای زیر ارائه میشود::


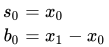
و برای توسط:: که در آن () «عامل هموارسازی داده» و () «عامل هموارسازی روند» است.

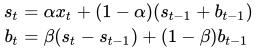


پیشگویی فراتر از توسط تقریب زیر ارائه میشود:: .
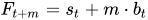
تعیین مقدار اولیه به سلیقه بستگی دارد. گزینهای غیر از آنچه در بالا ذکر شد، برای برخی از ها است.


توجهداشته باشید که تعریفنشده است (هیچ برآوردی برای زمان ۰ وجود ندارد) و طبق تعریف که به خوبی تعریفشده است، بنابراین مقادیر بعدی قابل ارزیابی هستند.

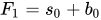
روش دوم، که به عنوان هموارسازی نمایی خطی براون (LES) یا هموارسازی نمایی دوگانه براون شناخته میشود، تنها یک عامل هموارسازی دارد:[۱۳]:
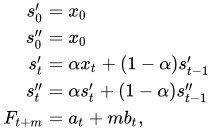
که در آن ، سطح برآوردشده در زمان ، و ، روند برآوردشده در زمان ، به صورت زیر ارائه میشوند::

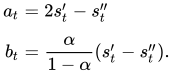
هموارسازی نمایی سهگانه (هولت-وینترز)
هموارسازی نمایی سهگانه، هموارسازی نمایی را سه بار اعمال میکند که معمولاً زمانی استفاده میشود که سه سیگنال با فرکانس بالا وجودداشته باشد که باید از یک سری زمانی مورد مطالعه حذف شوند. انواع مختلفی از فصلیبودن وجود دارد: ماهیت «ضربشونده» و «جمعی». ضربشونده به این معنی است که اندازه اثر فصلی به سطح فعلی بستگی دارد، در حالی که اثرات فصلی جمعی چنین نیستند.
اگر در «هر» تابستان ۱۰٬۰۰۰ بستنی بیشتر از زمستان بفروشیم، فصلیبودن «جمعی» است. با این حال، اگر در تابستان ۶ برابر بیشتر از زمستان بستنی بفروشیم، به این معنی است که تفاوت در مقادیر فروش همراه با خود سطح تغییر میکند: در سالهایی که مصرف کلی بیشتر است، تفاوت بین تابستان و زمستان بیشتر است و بالعکس. بنابراین اثر «ضربشونده» است. فصلیبودن ضربشونده را میتوان به عنوان یک عامل ثابت و فصلیبودن جمعی را به عنوان یک مقدار مطلق نمایش داد.[۱۴]
هموارسازی نمایی سهگانه برای اولین بار توسط دانشجوی هولت، پیتر وینترز، در سال ۱۹۶۰ پس از خواندن کتابی در زمینه پردازش سیگنال از دهه ۱۹۴۰ درباره هموارسازی نمایی پیشنهاد شد.[۱۵] ایده نوآورانه هولت، تکرار فیلتر کردن به تعداد فردِ بزرگتر از ۱ و کوچکتر از ۵ بود که در میان محققان دورههای پیشین محبوب بود.[۱۵] اگرچه فیلتر کردن بازگشتی قبلاً استفاده شده بود، اما دو بار و چهار بار اعمال میشد تا با حدس هادامارد مطابقت داشته باشد، در حالی که کاربرد سهگانه نیازمند بیش از دو برابر عملیاتِ همگشت منفرد بود. استفاده از کاربرد سهگانه به عنوان یک تکنیک قاعده سرانگشتی در نظر گرفته میشود، نه روشی مبتنی بر مبانی نظری، و اغلب توسط متخصصان بیش از حد مورد تأکید قرار گرفته است.</ref>
فرض کنید دنبالهای از مشاهدات داریم که در زمان با یک چرخه تغییرات فصلی به طول آغاز میشود. این روش یک خط روند برای دادهها و همچنین شاخصهای فصلی محاسبه میکند که مقادیر موجود در خط روند را بر اساس جایگاه نقطه زمانی در چرخه به طول وزندهی میکند.

اجازه دهید نشاندهنده مقدار هموارشده بخش ثابت برای زمان ، دنبالهای از بهترین برآوردها از روند خطی که بر تغییرات فصلی تحمیل شدهاند، و دنبالهای از عوامل اصلاح فصلی باشد. ما قصد داریم را در هر زمان در چرخهای که مشاهدات در آن قرار دارند، برآورد کنیم. به عنوان یک قاعده سرانگشتی، حداقل دو فصل کامل (یا دوره) از دادههای تاریخی برای مقداردهی اولیه مجموعهای از عوامل فصلی مورد نیاز است.


خروجی این الگوریتم دوباره به صورت نوشته میشود که برآوردی از مقدار در زمان بر اساس دادههای خام تا زمان است. هموارسازی نمایی سهگانه با فصلیبودن ضربی توسط فرمولهای زیر ارائه میشود[۱]

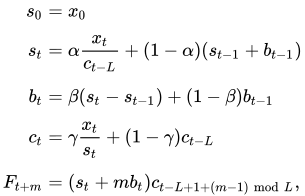
که در آن () «عامل هموارسازی داده»، () «عامل هموارسازی روند» و () «عامل هموارسازی تغییرات فصلی» است.


فرمول کلی برای برآورد اولیه روند عبارت است از
- .
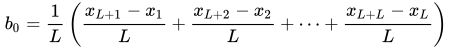
تنظیم برآوردهای اولیه برای شاخصهای فصلی برای کمی پیچیدهتر است. اگر تعداد چرخههای کامل موجود در دادههای شما باشد، آنگاه

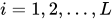

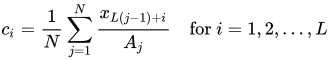
که در آن
- .
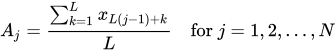
توجه داشته باشید که مقدار متوسط در -امین چرخه از دادههای شما است.


این منجر به نتیجه زیر میشود:
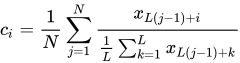
هموارسازی نمایی سهگانه با فصلیبودن جمعی توسط ارائه میشود:
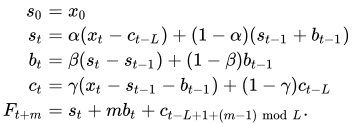
پیادهسازیها در بستههای آماری
- آر (زبان برنامهنویسی): تابع HoltWinters در بسته stats[۱۶] و تابع ets در بسته forecast[۱۷] (یک پیادهسازی کاملتر که عموماً منجر به عملکرد بهتری میشود[۱۸]).
- پایتون (زبان برنامهنویسی): ماژول holtwinters از بسته statsmodels امکان هموارسازی نمایی ساده، دوگانه و سهگانه را فراهم میکند.
- آیبیام بسته آماری برای علوم اجتماعی شامل روشهای ساده، ساده فصلی، روند خطی هولت، روند خطی براون، روند میرا، وینترز جمعی و وینترز ضربی در رویه مدلسازی سری زمانی در بستههای آماری Statistics و Modeler خود است. ویژگی پیشفرض Expert Modeler هر هفت مدل هموارسازی نمایی و مدلهای مدل خودهمبسته میانگین متحرک را با دامنهای از مقادیر غیرفصلی و فصلی p، d و q ارزیابی کرده و مدلی را با کمترین آماره معیار اطلاع بیزی-شوارتز انتخاب میکند.
- استتا: دستور tssmooth[۱۹]
- لیبرهآفیس 5.2[۲۰]
- مایکروسافت اکسل 2016[۲۱]
- جولیا (زبان برنامهنویسی): بسته TrendDecomposition.jl[۲۲] هموارسازی نمایی ساده و دوگانه و رویه پیشگویی هولت-وینترز را پیادهسازی میکند.
همچنین ببینید
پانویس
- 1 2 3 "NIST/SEMATECH e-Handbook of Statistical Methods". NIST. Retrieved 2010-05-23.
- 1 2 Oppenheim, Alan V.; Schafer, Ronald W. (1975). Digital Signal Processing. Prentice Hall. p. 5. ISBN 0-13-214635-5.
- ↑ Brown, Robert G. (1956). Exponential Smoothing for Predicting Demand. Cambridge, Massachusetts: Arthur D. Little Inc. p. 15.
- ↑ Holt, Charles C. (1957). "Forecasting Trends and Seasonal by Exponentially Weighted Averages". Office of Naval Research Memorandum. 52. reprinted in Holt, Charles C. (January–March 2004). "Forecasting Trends and Seasonal by Exponentially Weighted Averages". International Journal of Forecasting. 20 (1): 5–10. doi:10.1016/j.ijforecast.2003.09.015.
- ↑ Brown, Robert Goodell (1963). Smoothing Forecasting and Prediction of Discrete Time Series. Englewood Cliffs, NJ: Prentice-Hall.
- ↑ "NIST/SEMATECH e-Handbook of Statistical Methods, 6.4.3.1. Single Exponential Smoothing". NIST. Retrieved 2017-07-05.
- ↑ Nau, Robert. "Averaging and Exponential Smoothing Models". Retrieved 26 July 2010.
- ↑ "Production and Operations Analysis" Nahmias. 2009.
- ↑ Čisar, P., & Čisar, S. M. (2011). "Optimization methods of EWMA statistics." Acta Polytechnica Hungarica, 8(5), 73–87. Page 78.
- ↑ 7.1 Simple exponential smoothing | Forecasting: Principles and Practice.
- ↑ Nahmias, Steven; Olsen, Tava Lennon. Production and Operations Analysis (7th ed.). Waveland Press. p. 53. ISBN 9781478628248.
- ↑ "6.4.3.3. Double Exponential Smoothing". itl.nist.gov. Retrieved 25 September 2011.
- ↑ "Averaging and Exponential Smoothing Models". duke.edu. Retrieved 25 September 2011.
- ↑ Kalehar, Prajakta S. "Time series Forecasting using Holt–Winters Exponential Smoothing" (PDF). Retrieved 23 June 2014.
- 1 2 Winters, P. R. (April 1960). "Forecasting Sales by Exponentially Weighted Moving Averages". Management Science. 6 (3): 324–342. doi:10.1287/mnsc.6.3.324.
- ↑ "R: Holt–Winters Filtering". stat.ethz.ch. Retrieved 2016-06-05.
- ↑ "ets {forecast} | inside-R | A Community Site for R". inside-r.org. Archived from the original on 16 July 2016. Retrieved 2016-06-05.
- ↑ "Comparing HoltWinters() and ets()". Hyndsight (in American English). 2011-05-29. Retrieved 2016-06-05.
- ↑ tssmooth in Stata manual
- ↑ "LibreOffice 5.2: Release Notes – the Document Foundation Wiki".
- ↑ "Excel 2016 Forecasting Functions | Real Statistics Using Excel".
- ↑ TrendDecomposition.jl Julia implementation of exponential smoothing and Holt-Winters forecasting procedure
پیوند به بیرون
- یادداشتهای سخنرانی در مورد هموارسازی نمایی (رابرت ناو، دانشگاه دوک)
- هموارسازی داده توسط جان مکلون، پروژه نمایشهای ولفرام
- رویکرد هولت-وینترز به هموارسازی نمایی: ۵۰ ساله و همچنان قدرتمند توسط پل گودوین (۲۰۱۰) فورسایت: مجله بینالمللی پیشگویی کاربردی
- الگوریتمهایی برای سریهای زمانی با فواصل نامنظم: میانگینهای متحرک و سایر عملگرهای غلتان توسط آندریاس اکنر
| |||||||||||||||||||||
| |||||||||||||||||||||
| |||||||||||||||||||||
| |||||||||||||||||||||
| |||||||||||||||||||||
| |||||||||||||||||||||
| |||||||||||||||||||||


منابع
- مشارکتکنندگان ویکیپدیا. «[en:Template:Quantitative forecasting methods Template:Quantitative forecasting methods]». در دانشنامهٔ ویکیپدیای انگلیسی.
- پیشبینی آماری
- تحلیل سری زمانی